アクセスログに GPTBot や ClaudeBot が並び、robots.txt で AIクローラーを止めるべきか迷っている担当者の方は多いはずです。
多くの企業サイトに向くのは全面拒否ではなく、学習用のクローラーだけを断り、AI検索用は通す設定です。
AIクローラーとは、生成AIの会社が自動でWebページを読みに来るプログラムのことです。読みに来る目的は3つに分かれていて、サイトの入口に置くファイル「robots.txt」では、目的ごとに別の名前を指定して許可と拒否を決めます。AI検索での最適化を指す言葉は、AIO(AI Optimization)のほかにLLMO(Large Language Model Optimization)、GEO(Generative Engine Optimization)、AEO(Answer Engine Optimization)などがあり、業界でまだ呼び方が統一されていません。本メディアではこれらを総称して「AIO」と表記します。AI検索での自社の見え方を計測するツールとコンサルティングを提供する株式会社AI Hackが、3つの違いを切り分けたうえで、どれを許可しどれを拒否するかの判断手順をまとめます。
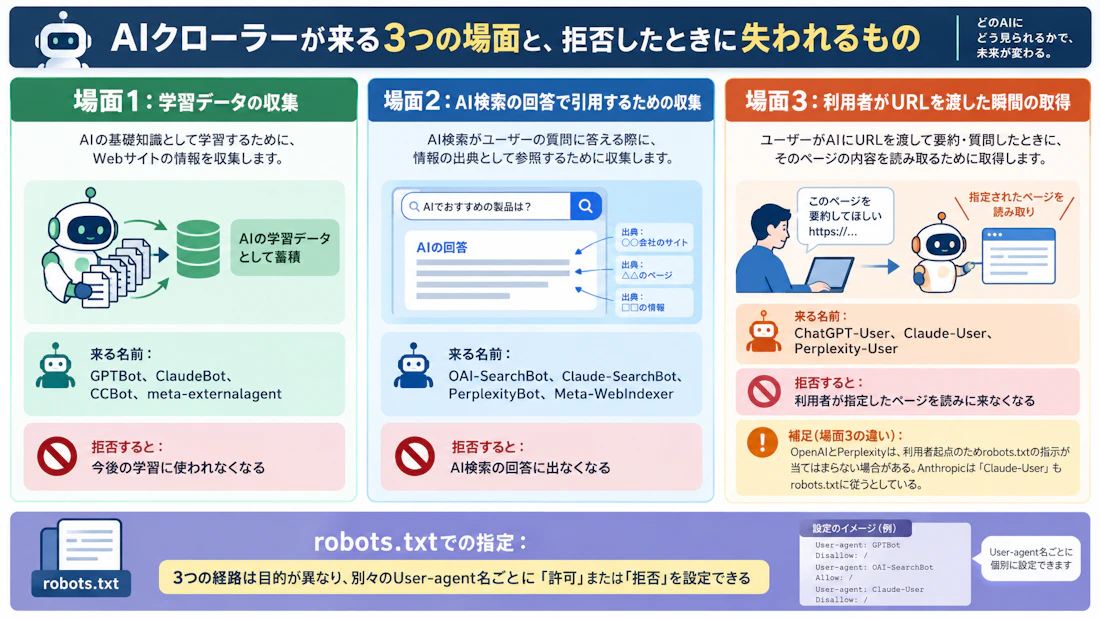
AIクローラーには「学習用」「AI検索用」「ユーザー操作時」の3種類がある
AIクローラーは目的ごとに3つに分かれ、robots.txt でも別々に指定します。「GPTBot は拒否しておけば安全ですよね」と聞かれることが多いのですが、それで止まるのは3つのうち1つだけです。残りの2つは別の名前で動いています。
学習のために集めるクローラー
AIの中身を作るための材料として、ページをまとめて集める巡回です。GPTBot や ClaudeBot、CCBot がこれにあたります。拒否すると、今後の学習に自社のページが使われなくなります。
AI検索の回答のために集めるクローラー
AIが回答を書くときに引用する候補を探す、定期的な巡回です。OAI-SearchBot や Claude-SearchBot、PerplexityBot がこれにあたります。ここを止めると、AIの回答に自社が出てこなくなる方向に働きます。私たちは、この区分だけは安易に拒否しない方がよいと考えています。
ユーザーがURLを渡した瞬間の取得
人がチャット欄にURLを貼ったときだけ走る取得です。ChatGPT-User や Claude-User、Perplexity-User が動きます。扱いは会社ごとに違い、OpenAIとPerplexityは利用者が起点のため robots.txt の指示が当てはまらない場合があるとしています(Search Engine Journal「Anthropic's Claude Bots Make Robots.txt Decisions More Granular」、2026年2月)。一方で Anthropic は、Claude-User も robots.txt に従うと明記しています(Anthropic「Does Anthropic crawl data from the web?」、2026年11月確認)。人がその場でページを読ませる使い方は、AIブラウザの主要サービスと企業サイトが今すべき備えで扱った流れとともに増えています。
次の図は、同じサイトに対して、どの場面でどの名前のアクセスが来るのかを並べたものです。
主要AIクローラー一覧:運営・用途・robots.txt に書く名前・拒否したときに起きること
覚えるべきは名前そのものではなく、「学習用か、AI検索用か、利用者の操作に伴う取得か」の3択です。表は右端の「拒否したときに起きること」から読むと迷いません。内容は2026年11月時点で各社の公式ページを確認したものです。
クローラー名 | 運営 | 主な用途 | robots.txt に書く名前 | 拒否したときに起きること |
|---|---|---|---|---|
GPTBot | OpenAI | 学習用の収集 | GPTBot | 今後の学習に使われなくなる |
OAI-SearchBot | OpenAI | ChatGPTの検索の回答づくり | OAI-SearchBot | ChatGPTの検索の回答に出なくなる |
ChatGPT-User | OpenAI | 利用者がURLを渡したときの取得 | ChatGPT-User | 利用者が起点のため指示が届かない場合がある |
OAI-AdsBot | OpenAI | ChatGPTの広告に出したページの審査 | OAI-AdsBot | 広告として出すページの審査に使う取得が止まる |
ClaudeBot | Anthropic | 学習用の収集 | ClaudeBot | 今後の学習に使われなくなる |
Claude-SearchBot | Anthropic | Claudeの検索の回答づくり | Claude-SearchBot | Claudeの回答での見え方と正確さが下がる場合がある |
Claude-User | Anthropic | 利用者の質問に応じた取得 | Claude-User | 質問に応じてページを取りに来なくなる |
PerplexityBot | Perplexity | Perplexityの検索結果づくり | PerplexityBot | 検索結果に本文が載らなくなる |
Perplexity-User | Perplexity | 利用者の操作に応じた取得 | Perplexity-User | 利用者が起点のため指示が届かない場合がある |
Google-Extended | 集めた内容をGeminiの学習などに使ってよいかの設定 | Google-Extended | Geminiの学習などに使われなくなる | |
Applebot-Extended | Apple | 集めた内容をAppleのAIの学習に使ってよいかの設定 | Applebot-Extended | Appleの基盤モデルの学習に使われなくなる |
meta-externalagent | Meta | 学習用の収集 | meta-externalagent | 今後の学習に使われなくなる |
Meta-WebIndexer | Meta | Meta AIの回答での引用 | meta-webindexer | Meta AIの回答で引用・リンクされにくくなる |
CCBot | Common Crawl | 公開データセット向けの収集 | CCBot | 公開データセットに載らなくなる |
出典:OpenAI「Overview of OpenAI Crawlers」、Perplexity「How does Perplexity follow robots.txt?」、Google「List of Google's common crawlers」、Apple「About Applebot」、Meta「Meta Web Crawlers」、Common Crawl「CCBot」、前掲のAnthropicのサポート記事(いずれも2026年11月確認)
なお robots.txt の名前(User-agent)は大文字と小文字を区別しません。
表の要点は、同じ会社でも学習用とAI検索用が別の名前で管理されていることです。OpenAI の OAI-AdsBot は、ChatGPTの広告として申し込まれたページを審査するためのもので、それ以外の用途は公式には示されていません。Meta も学習用と引用用を分けているため、meta-externalagent を拒否しても Meta AI の回答での引用が丸ごと止まるわけではありません。
Google-Extended と Applebot-Extended は「来るボット」ではなく「使ってよいか」の設定
この2つはページを取りに来ません。すでに集めた内容を学習などに使ってよいかを伝えるための名前です。そのためアクセスログにも出てきません。Google-Extended を拒否しても Google 検索の掲載と順位は変わりません(Google「List of Google's common crawlers」、2026年11月確認)。Apple も、Applebot-Extended の指定は検索機能に影響しないとしています(Apple「About Applebot」、2026年11月確認)。私たちは、この2つを「拒否しても失うものが小さい設定」として扱っています。
robots.txtの書き方3パターン(全許可/学習だけ拒否/全面拒否)
書き方は3つのうちどれかに収まります。前提として robots.txt はサイトの直下(例: example.com/robots.txt)に置き、誰でも開けます。名前ごとにグループを分けて書き、各グループは訪問者が名乗る名前(User-agent)の行から始めます。
次は、何も指定しない状態と同じ「全許可」を明示する書き方です。
User-agent: *
Allow: /
この形を使うのは、ほかの行で広く拒否していて、例外を示したいときだけで足ります。
次が、多くの企業サイトに向く「学習用だけを断る」書き方です。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: meta-externalagent
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: meta-webindexer
Allow: /
自社の方針に合わせて書き換えるのは Disallow と Allow の部分で、学習も許容するなら上半分を Allow に変えます。
最後が全面拒否です。
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: meta-externalagent
Disallow: /

User-agent: meta-webindexer
Disallow: /

User-agent: Claude-User
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /
ChatGPT-User と Perplexity-User は利用者が起点のため robots.txt では止まらない場合があり、止めたい場合は WAF 側で扱います。
これはAIの回答に出なくてよい場合だけの選択で、迷うなら2つ目が安全です。
よくあるミスは両方向にあります。片方は GPTBot だけを拒否し、AI検索用を書き忘れたり、robots.txt で止まらない利用者起点の取得まで止めたつもりになったりする例。もう片方は「User-agent: *」で全部を拒否し、引用の機会まで捨てる例です。なお書き換えてもすぐには反映されず、クローラー側が最大24時間前の内容を使う場合があります(Meta「Meta Web Crawlers」、2026年11月確認)。似た名前の llms.txt はAI向けに本文の場所を案内する別のファイルで、書き方はllms.txtの書き方|Googleは不要と明言、効果は賛否両論で扱っています。
学習用を拒否すると何を失い、何は失わないのか
学習用の指定とAI検索用の指定は、別々に扱われます。つまり「学習には使わせないが、回答には引用されたい」という選び方ができます。失わないものから確認します。
失わないのは、AI検索での引用の資格です。OAI-SearchBot を許可していれば、GPTBot を拒否してもChatGPTの検索の回答の対象からは外れません。Google 検索の掲載と順位も、先に書いたとおり変わりません。
失うのは、AI検索用まで止めた場合の露出です。回答の中の出典表示、そこからの流入、名前が挙がる機会が減ります。自社名で直接聞かれた場合以外、候補として出てこなくなります。
実際の設定も、学習用のほうが多く断られています。上位1万サイトから読み取れた robots.txt のうち、GPTBot を全面的に拒否していたのは14.3%、AI検索用のクローラーを拒否していたのは10.8%でした(aicrawlercheck「AI Crawler robots.txt Study 2026」、2026年10月)。裏を返すと、多くのサイトはそもそもAI向けの行を書いていない状態です。
実務では、許可の設定を変えた前後で、AIの回答における自社の言及と引用がどう動いたかを定点観測し、設定変更の影響かどうかを切り分けています。引用される中身の作り方はAIに引用されるコンテンツの作り方にまとめました。
自社はどこまで許可すべきか:3つの質問で決める判断フロー
3つの質問に順番に答えれば、全許可・学習のみ拒否・全面拒否のどれかに着地します。下の図は、その分かれ道を1枚にしたものです。
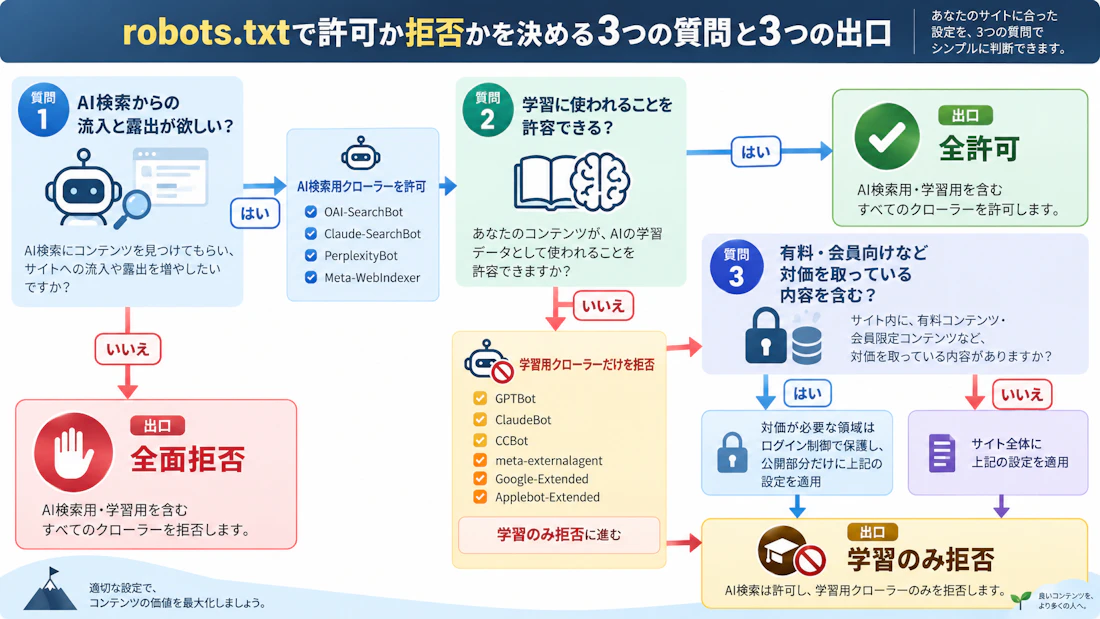
質問は、流入の要否、学習利用の可否、有料・会員向けの有無の3つです。
- AI検索からの流入と露出が欲しいか。欲しければ、AI検索用は許可します。
- 学習に使われることを許容できるか。許容できなければ、学習用だけを拒否します。
- 有料・会員向けなど、対価を取っている内容を含むか。含むなら、その領域は別扱いにします。
有料・会員コンテンツのサイト
公開部分と会員部分で扱いを分けます。本文を読ませたくない領域は、ログイン後にだけ表示する作りで守ってください。公開している紹介ページまで閉じると、サービスの存在自体がAIの回答に出なくなります。
メディア・オウンドメディア
流入が収益に直結するため、AI検索用は開けるのが基本線だと見ています。学習用を断るかどうかは、記事の二次利用に関する方針次第です。
BtoBコーポレートサイト
指名で調べられたときに、AIが正しく答えられる状態のほうが得です。全面拒否にすると、AIが自社以外の古い情報を拾い、事実と違う内容を答えるハルシネーション(生成AIが事実でない内容を出す現象)が起きやすくなるおそれがあります。
設定後の確認:サーバーログとCDNのログでAIクローラーの訪問を見る
設定したら、ログで到達を確かめるところまでが作業です。手順は、保存場所の確認、名前での絞り込み、応答の確認、週単位の比較の4つです。
- ログの保存場所と保存期間を確認する。サーバー側だけでなく、配信を代行する仕組み(CDN)の側にも記録が残ります。
- 表に挙げた名前で絞り込む。「GPTBot」「OAI-SearchBot」のように文字列で検索すれば足ります。
- 応答の番号を見る。200なら届いており、403は拒否、429は回数の上限に当たった合図です。
- 週単位で件数を比べる。設定を変えた週とその前の週を並べると、変化が読み取れます。
名前は誰でも名乗れるため、OpenAI や Common Crawl が公開しているアクセス元のアドレス一覧と突き合わせると確実です(OpenAI「Overview of OpenAI Crawlers」、Common Crawl「CCBot」、2026年11月確認)。先に書いたとおり、Google-Extended と Applebot-Extended はログには現れません。
実務では、同じ質問を複数のAIに繰り返し尋ね、言及と引用の状況として集計しています。ログに来訪が見えることと、回答に出ていることは別なので、両方を見る必要があります。測り方はAIO(LLMO)診断とは?AI検索での自社の見え方を確認する手順にまとめました。
許可したはずなのに来ない:WAF・CDNのボット対策が止めている典型例
robots.txt で許可していても、その手前で止まっていれば届きません。通る順序は、配信を代行する仕組み(CDN)と不正アクセスを防ぐ仕組み(WAF)、サーバー、robots.txt です。下の表は、よくある症状と見る場所の対応です。
症状 | 考えられる原因 | 確認する場所 | 直し方 |
|---|---|---|---|
許可したのにログに来ない | 配信側の既定でAI向けのボットが遮断されている | CDN管理画面のボット設定 | 区分ごとに許可し直す |
一部のページだけ来ない | 広告が出るページだけ遮断する既定 | 同じ画面のページ単位の設定 | 対象ページの扱いを変える |
429が並ぶ | 一定時間あたりの回数制限 | サーバーとCDNの制限設定 | クローラー向けの上限を緩める |
403が返っている | 不正アクセス対策の自動判定や地域・アドレスでの遮断 | WAFのログ | 公式のアドレス一覧を許可対象にする |
robots.txt 自体が開けない | 配信設定の誤り | ブラウザでそのURLを開く | 正常に表示されるよう直す |
表のうち上の2行は、自社で設定した覚えがなくても起きます。上位1,000サイトのうち通常のブラウザに応答した549サイトを調べた調査では、robots.txt では許可しているのに主要なクローラーのどれかを実際には拒んでいたサイトが14.2%ありました(crawlreadiness「AI crawler access across the top 1,000 websites」、2026年10月)。
配信側の既定も動きます。Cloudflare では、広告で収益化していると申告して新しく追加されたドメインについて、検索用は許可、学習用は robots.txt で学習不可を宣言する「Disallow AI Training」、利用者の代行をするボットは広告が表示されるページでのみ遮断、という既定が適用されています(Cloudflare「Have it both ways: stay discoverable in search while disallowing AI training」、2026年9月15日公開/2026年11月確認)。学習の扱いは、許可/学習不可の宣言/遮断(広告が出るページ限定を含む)に分かれました。旧来の一括遮断(Block AI Bots)だけを使っていたドメインは、検索用は許可、学習用は学習不可の宣言、代行ボットは広告が出るページのみ遮断へ自動で移されたため、検索クローラーは止まりません。一方、新しい設定で学習用を自分で「遮断(広告が出るページ限定を含む)」にしたサイトでは、検索と学習を兼ねる Googlebot なども遮断の対象になります(同ブログ、Cloudflare、2026年9月15日)。私たちは、AIの回答に出ない原因を探すとき、robots.txt より先にこの層を確認しています。
robots.txtでできないこと:強制力・過去の学習・GoogleのAI回答
robots.txt は「取りに来てよいか」を伝えるお願いで、取った後の使われ方までは決められません。守らない相手もいますし、名前を偽るアクセスもあります。すでに学習に使われた分を、後から遡って取り消すこともできません。
noindex と Disallow の違い
Disallow は「取りに来ないで」という指示、noindex は「検索結果に出さないで」というページ側の指定です。両方を同時に使うと、取りに来られないせいで noindex が読まれず、検索結果に残り続けることがあります。検索結果から外したいなら、取得は許可して noindex を読ませます。
GoogleのAI回答は Google-Extended では外れない
AI Overviews と AI Mode は、Google検索の中の機能です。そのため Google-Extended を拒否しても外れません。関係するのは Googlebot への指示と、検索結果に出す抜粋の制御、そして Search Console 側の設定です。2026年6月には、検索からは外れずにAI回答への掲載だけを外す設定が Search Console で英国から提供され始め、その後ほかの国のサイトにも広がりました(Search Engine Journal「What Opting Out Of Google's AI Search Features Means Now」、2026年8月)。流入への影響はAI Overviewsで流入が減る理由とサイト側にできることで扱っています。
まとめ
今日できることは3つで、現状の確認、方針の選択、到達の確認です。
- 自社の robots.txt を開き、AI向けの行があるか確かめる。
- 全許可・学習のみ拒否・全面拒否から1つ選び、書き換える。
- 1〜2週間後にログを見て、実際に届いているか確認する。
各社の名前も、配信側の既定も変わります。一度決めて終わりにせず、半年ごとに見直す前提で選ぶのがよいと考えています。AI検索全体の進め方はAI検索対策(AIO)とは?SEOとの違いと引用される施策にまとめているので、設定の次の一手はそちらをご覧ください。自社がいまAIの回答にどう出ているかを先に知りたい場合は、無料AIO診断(実測)をお問い合わせフォームから申し込めます。