ChatGPTに出た自社の情報の間違いは、投稿を消すように削除するのではなく、参照される情報の側を正して置き換えていくのが基本です。 個別の回答は質問のたびに生成されるため、他人の画面に出た回答を後から書き換えることは原則できません。一方で、モデルや検索が参照する情報環境、つまり自社サイトと第三者ソースは企業側で作り替えられます。この記事では、広報・IR・法務の担当者が「何を、どの順で、誰とやるか」を決められるところまで整理します。
なお、AIの回答の中で自社が正しく取り上げられるよう整える取り組みは、AIO(AI Optimization)、LLMO(大規模言語モデル最適化)、GEO(生成エンジン最適化)、AEO(回答エンジン最適化)など複数の呼び方があります。本メディアではこれらを総称して『AIO』と表記します。
「ChatGPTにこう出ていますよ」と言われたとき、最初に確認すること
先に結論をお伝えすると、慌てて否定や公表に動く前に、起きていることを3種類に切り分けてください。
取引先から画面のスクリーンショットが送られてくる。採用候補者が旧社名や、すでに終了した事業を前提に面接に来る。相談の入り口はたいていこの形です。ここで大事なのは、どのタイプの問題なのかを最初に見極めることです。
- 自社・自社製品・代表者について事実と違う内容が語られている(本記事が扱う範囲)
- ChatGPTの回答一般が事実と違う=ハルシネーション(幻覚とも呼ばれます)。もっともらしい文章の形で誤りを生成してしまう現象です
- 自分のアカウントの登録情報や課金情報が違う(OpenAIのサポート案件で、本記事の対象外)
もう一つ、初めに区別しておきたい線があります。モデルが内部から誤って生成しているのか、検索やブラウジングで参照した第三者ページの誤りをそのまま引いているのか、です。前者は情報環境を厚くして塗り替える話、後者は引用元そのものを直す話で、打ち手がまったく違います。
放置しづらいのは、企業情報に触れる入口としてAIの比重が増しているからです。ICT総研「2026年2月 生成AIサービス利用動向に関する調査」(2026年2月公表)では、ネットユーザーのうち直近1年以内に生成AIサービスを使った人は54.7%、生成AIサービス利用者に占める利用率はChatGPTが36.2%(次いでGemini 25.0%)と報告されています。すでに社内で共有済みか未共有かにかかわらず、誤った説明文が「自己紹介文」として何度も引用され続ける構造がある、という前提で動くのが安全です。
消せるもの、消せないもの — 打ち手の全体像を先に押さえる
結論として、回答そのものの削除はほぼできず、効くのは参照元の是正です。線引きを先に置きます。
- 消せない:過去に生成された回答、他人の画面にすでに出た回答
- 申請できる:個人に関する不正確・過剰・無関係な情報を回答に出さないよう求めるプライバシー申請。OpenAIのプライバシーポータルから提出でき、表現の自由や公共の利益との調整を含めて個別に判断されるため、拒否され得ます(OpenAIヘルプセンター、2026年8月確認)。法人としての記述そのものは個人データの申請対象外ですが、代表者個人の氏名や経歴の誤りは射程に入り得ます
- 報告できる:回答への低評価やコンテンツ報告フォームからの報告。受け付けはされますが、個別の回答内容の修正を約束する窓口ではありません(OpenAIヘルプセンター、2026年8月時点)
- 自分で直せる:自社サイトの記述、構造化データ、第三者媒体の記述
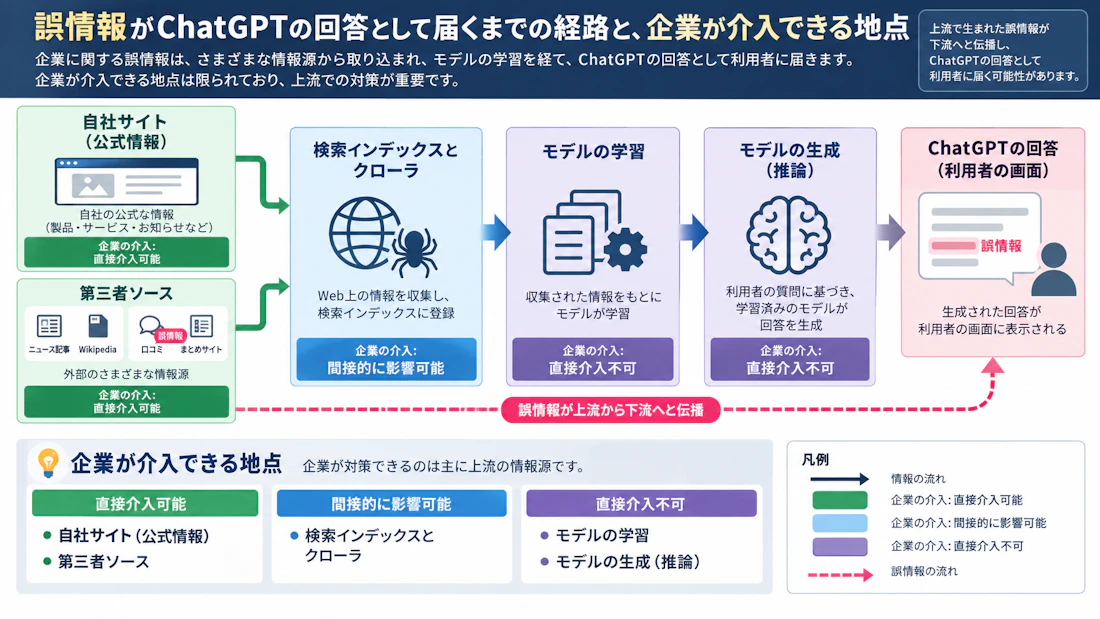
つまり、最短でやるべき初動は「記録する → 影響度を判定する → 自社の一次情報を直す」の3つです。以降はこの順に見ていきます。
なぜChatGPTは自社を間違えるのか — 5つの発生源
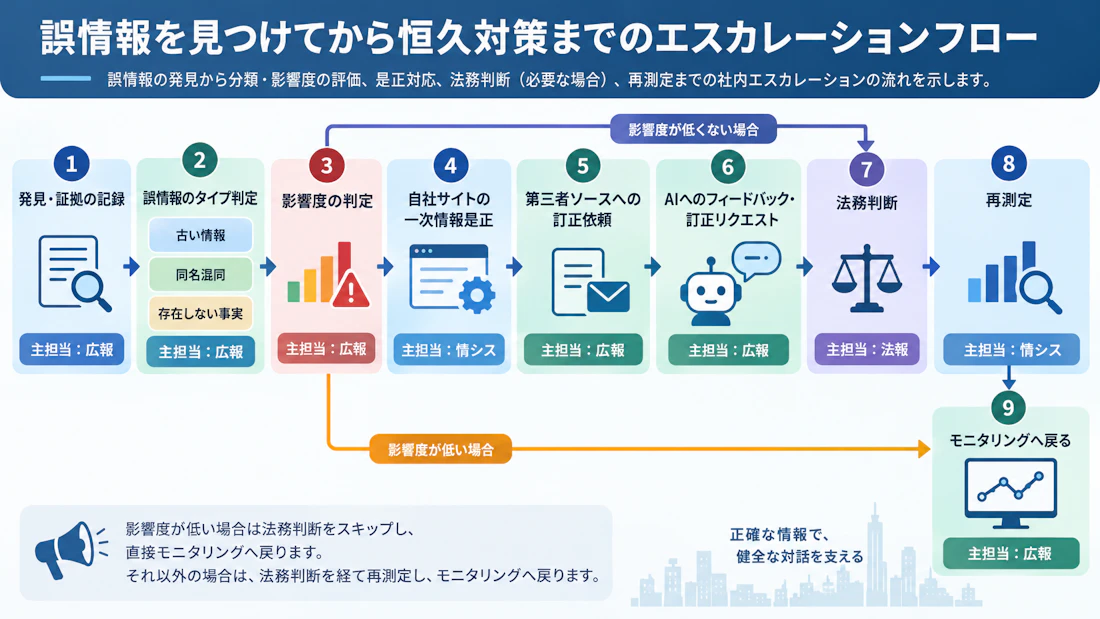
原因は5つに分かれ、原因ごとに効く打ち手が違います。生成の仕組み自体を押さえたい方はAIのハルシネーションが起きる仕組みとリスクを先に読むと、以下の切り分けが理解しやすくなります。
①学習時点が古い
モデルの学習データには時点の区切りがあり、旧社名・買収前の資本関係・終売製品がそのまま語られます。
②同名企業・同名製品とのエンティティ混同
エンティティとは、AIや検索が「同一の対象」として扱う実体の単位です。日本語の社名は同名・類似名が多く、別会社の沿革や代表者名が混ざりやすい領域です。
③参照した第三者ページ自体が間違っている
まとめサイト、古いニュース、誤ったWikipediaの記述がそのまま引用されるケースです。引用元が表示される仕組みはChatGPT searchの特徴と使い方で整理しています。
④確率的生成そのもの
情報が薄い企業ほど、もっともらしい穴埋めが起きます。予防と監視の設計はAI検索で誤情報が表示される原因と企業側の対策が参考になります。
⑤同じ質問でも回答が揺らぐ
一度直っても別のセッションでは旧情報が出ます。当社が継続して計測している範囲でも、同じ質問への回答は反復のたびに揺らぎが見られます。単発の確認(N=1)で「直った/直っていない」と報告しないでください。
誤情報のタイプ別に整理すると、古い情報が残っているケースは自社の一次情報の更新日と沿革の明示が最優先、同名混同は構造化データ(Organization/Product)や sameAs で公式アカウント・外部プロフィールを結び付けエンティティを明示することが効きます。存在しない事実が生成されているケースは、そもそも正しい記述が世の中に薄いことが多く、自社サイトと第三者媒体の両方で事実を流通させる以外に近道がありません。
見つけた直後の48時間 — 証拠の残し方と影響度の判定
記録の粒度が、その後の申請・法務判断・効果測定すべての精度を決めます。
記録すべき5点
- 入力したプロンプト全文
- 回答全文(テキストとスクリーンショットの両方)
- 実行日時
- 利用環境(ログインの有無、検索・ブラウジング機能のオン/オフ、利用したエンジン)
- 回答に付いていた引用元URL
再現手順を作る
同じ質問を独立したセッションで複数回、可能なら複数エンジンで試します。同じ会話の中での追い質問は文脈を引き継ぐため、独立した再現とは数えません。
影響度の判定軸
誤りの種類(単なる事実誤り/信用に関わる内容/個人に関する情報)、露出しやすさ(社名単体で聞いても出るか、条件を重ねたときだけ出るか)、実害の有無(商談・採用・IRで指摘済みか)の3点で見ます。
誰に上げるか
広報が一次受け、信用や個人に関わる内容なら法務へ即エスカレーション、情シス・Web担当がサイト側の是正とクローラ設定を担当する、と先に決めておくと初動が止まりません。
打てる手を6つ並べて比べる
速さと効きの長さはトレードオフです。まず一覧で見てください。
打ち手 | 着手の速さ | 反映までの目安 | 必要リソース・専門性 | 効き方 | 限界・副作用 |
|---|---|---|---|---|---|
①自社サイトの一次情報整備(会社概要・沿革・製品ページ、構造化データ、sameAs) | 速い | 中期 | Web担当+広報 | 恒久寄り | 構造化データを入れれば引用が増えるとは言えない。記述の正確さが先 |
②第三者ソースの是正(業界メディアへの訂正依頼、Wikipedia、口コミ・まとめサイト) | 中 | 中〜長期 | 広報+外部折衝 | 恒久寄り | 自社で直接編集できず媒体側の判断に左右される |
③OpenAIへのフィードバック・訂正リクエスト | 速い | 不確実 | 法務+情シス | 限定的 | 対象範囲が限られ、回答一般の削除窓口ではない |
④定点モニタリング(固定プロンプトでの継続計測) | 速い | 即時(可視化のみ) | 担当工数またはツール | 間接的 | それ自体は誤情報を直さない。判断材料を作る手段 |
⑤法的対応(弁護士経由の通知、発信元媒体への請求) | 遅い | 長期 | 法務+外部弁護士 | 発信元には恒久的 | 射程は発信元。AIの回答自体を止める手段ではない |
⑥社内外コミュニケーション(想定問答、営業・CSへのFAQ配布、公式サイトでの訂正告知) | 最速 | 即時 | 広報+現場 | 一時的 | 実害は止まるが発生源は残る |
整理すると、速い手(③⑥)は今日の実害を止めるための応急処置、遅い手(①②⑤)は半年後に同じ質問をされたときの答えを変える手です。どちらか一方では終わりません。
優先順位の付け方
影響度が高い(信用に関わる、社名単体で再現する)なら①と⑥を即日、②③を並行、⑤は法務判断に委ねます。影響度が低ければ④に戻して様子を見る、で十分です。自社サイト側の整え方はAI検索の対策(AIO)の考え方も合わせてご覧ください。
よくある誤解と、打ち手の限界
「消す」発想と「遮断する」発想は、どちらも逆効果になり得ます。
誤解1「削除依頼を出せば消える」
回答は都度生成されるため、過去の回答を消すという概念がありません。プライバシー申請は個人に関する不正確・過剰・無関係な情報を回答に出さないよう求めるもので、個別判断で拒否され得ます(OpenAIヘルプセンター、2026年8月確認)。
誤解2「GPTBotをブロックすれば止まる」
OpenAIのクローラは役割別に分かれており、学習用のGPTBotと検索用のOAI-SearchBotは robots.txt で個別に制御できます。一方、利用者の求めに応じて取得するChatGPT-Userはユーザー起点であるため robots.txt が適用されない場合がある、と公式ドキュメントは説明しています(OpenAI公式ドキュメント、2026年8月確認)。遮断は守りに見えて、正しい自社情報が参照されにくくなる副作用のほうが大きくなりがちです。仕様は変わりやすいので、設定前に必ず最新版を確認してください。
誤解3「一度直ったのにまた間違う」
回答は確率的に揺らぎます。1回の確認で「解決済み」と社内報告しないことをおすすめします。
誤解4「誰かの責任を問える」
発信元媒体の記述に起因する場合と、モデルの生成に起因する場合で射程が違います。国内では情報流通プラットフォーム対処法が2025年4月1日に施行され、2025年4月にGoogle・LINEヤフー・Meta・TikTok・Xの5社、同年5月にドワンゴなど4社が大規模特定電気通信役務提供者として指定されています(総務省「情報流通プラットフォーム対処法」)。ただしこれは大規模プラットフォーム事業者に削除申出対応の迅速化・透明化を求める枠組みで、生成AIの回答そのものにどこまで及ぶかは個別の検討が必要です。名誉毀損・信用毀損の成否も含め、判断は必ず法務・弁護士に確認してください。企業側の体制整備の考え方は、AI事業者ガイドライン第1.2版(総務省・経済産業省、2026年3月31日公表)が参考になります。
まとめ:同じことを繰り返さないために
誤情報対応は一回のプロジェクトではなく、広報・法務の定例業務に組み込むのが現実的です。最低限やることは3つです。
- 監視する質問リスト(社名・代表者名・主力製品・比較質問)を固定し、複数エンジンで定期的に測る
- 窓口と判断基準(誰が受け、どこから法務に上げるか)を先に決めておく
- 是正後に再測定し、直ったかを反復回数付きで確認する
ただ、これを手作業で回すと工数が現実的でなくなります。5回の反復×3エンジン×4プロンプトでも60セッションになり、手作業では1回の計測だけで半日近くかかります。当社ではこの定点観測を自動化し、言及率(Mention Rate)・引用率(Citation Rate)・引用ドメインまで分解して見られるようにしています。計測ツールは月額10万円からご利用いただけます。ツールの選び方はAIO分析ツールの比較にまとめました。
まずは「自社について何がどう語られているか」を測るところからで構いません。ご相談はAI Hackまで。