社内の打ち合わせで「NLWebって、うちのサイトも対応が必要ですか」と聞かれた方は多いはずです。実装そのものを急ぐ必要はありません。先に効くのは、商品や記事の情報を機械が読める形に整えておくことです。
NLWebは、サイトの中身について人やAIが普通の言葉で質問でき、答えが返る状態をつくる公開の仕組みです。検索窓にキーワードを入れて一覧を眺める代わりに、「夏の出張に合うスーツはある?」と話しかけて答えが返る形を目指しています。
なお、AI検索での最適化を指す言葉は、AIO(AI Optimization)のほかにLLMO(Large Language Model Optimization)、GEO(Generative Engine Optimization)、AEO(Answer Engine Optimization)などがあり、業界でまだ呼び方が統一されていません。本メディアではこれらを総称して「AIO」と表記します。
NLWebとは何か|Microsoftが2025年に公開した仕組みを一言で説明する
NLWebは、自然な言葉で問い合わせられる窓口をサイト側に用意するための、誰でも使える取り組みです。自社サイトの中に、自社のデータだけで答える相談係を置くイメージが近いです。使うAIもサイト側で選べます。
これはMicrosoftが2025年5月の開発者向けイベント「Build」で発表したものです(Microsoft「Microsoft Build 2025: The age of AI agents and building the open agentic web」、2025年5月)。同じ発表では、AIが動き回るこれからのWebにとって、HTMLのような土台になりうるものだと位置づけられています。
設計したのは、RSSやschema.orgといった既存のWebの決まりごとを作ったR.V.グハ(R.V. Guha)氏で、Microsoftのコーポレートバイスプレジデント兼テクニカルフェローです(Microsoft「Introducing NLWeb」、2025年5月)。新しいタグを発明する話ではなく、すでにあるデータの再利用から始まる仕組みだということです。
誰でも試せるように、Pythonで書かれた一つの実装例がGitHubで公開されています(GitHub「nlweb-ai/NLWeb」、2026年10月確認)。ライセンスはMITで、無償で利用・改変できます。私たちは、この「既存の構造化データの上に乗る」という設計こそ、Web担当者が押さえるべき要点だと考えています。
NLWebと混同されやすい2つのもの
NLWebは、AIが言葉を扱う技術の総称ではありません。市販の会話型サイト内検索ツール全般を指す言葉でもなく、各社が同じやり方で実装できるようにした取り決めと、その参考になるコードを指します。
エージェンティックウェブという流れがNLWebを生んだ背景
きっかけは、人が自分でサイトを回る前提が崩れ始めたことです。利用者の代わりにAIが調べ、比べ、手続きまで進める使い方が広がりました。この姿をMicrosoftはオープンなエージェンティックウェブと呼んでいます(Microsoft「Microsoft Build 2025」、2025年5月)。
先に起きているのは、AIが答えをまとめてしまい、サイトまで人が来ない動きです。この変化はゼロクリック検索の記事で詳しく扱っています。
私たちAI Hackは、AIの回答に企業がどう登場するかを計測するツールを提供しています。その立場から見ると、「人に見てもらう入口」だけを整え続ける設計は、もう片側しか守れていないと感じます。だからサイト側にAIが質問できる窓口を置く、という発想が出てきました。
NLWebはどう動くのか
中で起きているのは、サイトの既存データを検索し、その結果をAIに答えさせる処理です。特別なデータベースを新しく作る話ではありません。順に見ていきます。
質問が答えになるまでの4ステップ
大きくは「材料を集める → 意味で探せる形に変える → 関連部分を取り出す → 答えを組み立てる」の4段階です。
- サイトがすでに持っている構造化データを集めます。構造化データとは、商品名・価格・在庫のように、意味のラベルを付けて機械に渡す書き方です。材料になるのはschema.orgやRSSといった既存の形式で、取り込み用の道具も一緒に公開されています(Microsoft「Introducing NLWeb」、2025年5月)。
- 集めた情報を、意味の近さで探せるデータベースに入れます。「安い ノートPC」と「低価格 ノートパソコン」を近いものとして扱える仕組みです。
- 質問が届いたら、関連する部分だけを取り出して言語モデルに渡します。言語モデルは、文章を読んで答えを組み立てるAIのことです。
- 答えは、schema.orgの型にそろえた機械が読みやすい形で返ります(GitHub「nlweb-ai/NLWeb」、2026年10月確認)。
実務では、この流れを「サイト内検索の結果を、AIが文章にして返しているだけ」と説明しています。入口が人とAIの2つある点を含めて、次の図にまとめました。
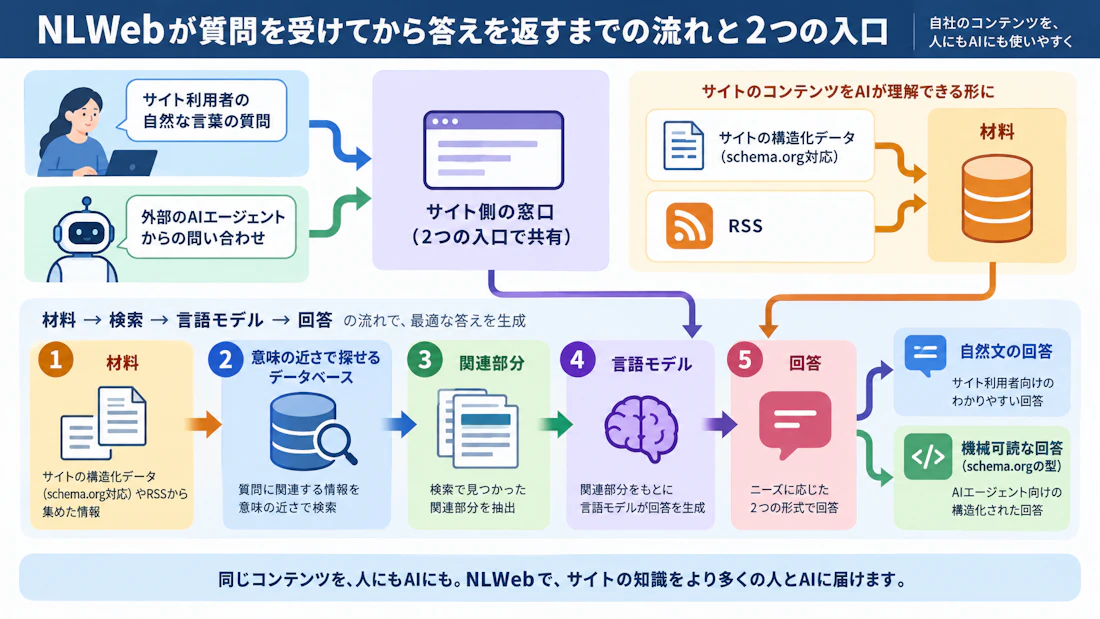
人の入口とAIの入口がNLWebでは同じになる
AIと外部の情報や道具をつなぐ共通の作法が、すでに広く使われています。これをMCPと呼びます。NLWebの窓口はそのMCPの接続口としても動くため、サイトの中身を外部のAIエージェントから見つけて使ってもらえます(Microsoft「Microsoft Build 2025」、2025年5月)。
取り決めの側では、質問の送り方と答えの返し方が決められています(NLWeb.ai「What is NLWeb?」、2026年10月確認)。使うOS・言語モデル・意味で探せるデータベースは複数の選択肢から選べる作りで、特定の1社に縛られません(GitHub「nlweb-ai/NLWeb」、2026年10月確認)。
NLWebとMCP・llms.txt・構造化データは何が違うのか
似た言葉が並びますが、4つは層が違います。表は「誰のために、どこに置くものか」を縦に読むと整理しやすいです。
NLWeb・MCP・llms.txt・構造化データを6つの軸で比べる
名前 | 目的 | 主な読み手 | 必要なもの | 置き場所 | 実装の重さ |
|---|---|---|---|---|---|
NLWeb | 質問に答える窓口を用意する | 人とAIの両方 | 構造化データ+言語モデル+意味で探せるデータベース | 自社のサーバーや利用中のサービス | 重い |
MCP | AIと外部の情報や道具をつなぐ | AI | つなぎ先の定義 | 自社サーバーまたは手元の端末 | 中くらい |
llms.txt | 読んでほしいページの一覧を示す | AI | 手で作ったリンク集 | サイト直下の固定ファイル | 軽い |
構造化データ | 中身の意味を機械に伝える | 検索エンジンとAI | ページ内の記述 | 各ページの中 | 中くらい |
要するに、下の2つは「置くだけ」、上の2つは「動かすもの」です。
4つは役割が違うため、互いの置き換えにはならない
NLWebは答える側の窓口、MCPはつなぐ作法、llms.txtは案内の紙、構造化データは中身のラベルにあたります。どれかを入れれば他が不要になる関係ではありません。
llms.txtについては、Google検索が生成AI機能に出るために必要ない施策として挙げています(Search Engine Journal「Google's llms.txt Guidance Depends On Which Product You Ask」、2026年5月)。この議論の詳細はllms.txtの書き方の記事にまとめています。
4つの関係は、言葉より配置で見たほうが早いので図にしました。
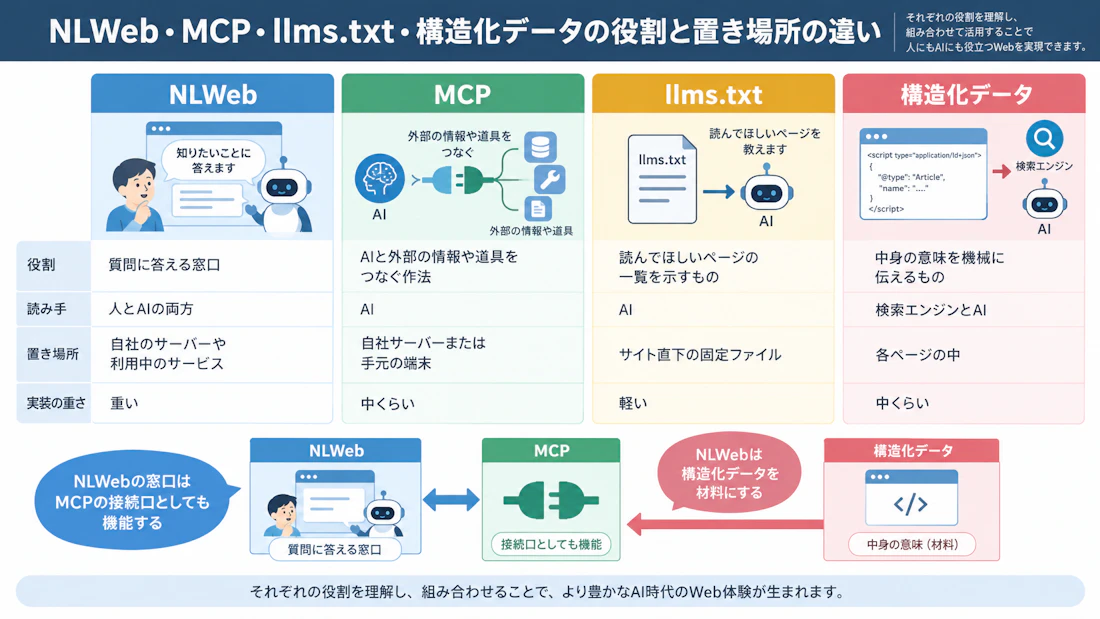
私たちは、この4つのうち先に手を入れる価値があるのは構造化データだと考えています。NLWebもMCPも、材料であるラベルが欠けていれば答えの質が上がらないためです。
企業サイトでNLWeb対応が変えること
変わるのは、サイトの「問い合わせ口」が増えることです。社内の問い合わせ対応に窓口が1つ増える、という感覚に近いと思います。
1つ目は、サイト内検索が会話型になる点です。「予算3万円以内で在庫があるもの」といった条件の重なった質問に、ページの一覧ではなく答えで返せます。2つ目は、外部のAIエージェントから直接問い合わせを受ける口ができる点です。
参考になるのは、商品・レシピ・観光情報・レビューのように一覧になる情報を持つサイトが想定されている点です(GitHub「nlweb-ai/NLWeb」、2026年10月確認)。私たちは、在庫や条件が多い事業ほど相性がよいと見ています。買い物の代行まで含む全体像はエージェンティックコマースの記事で扱っています。
ただし、これは検索順位やAIの回答での引用を保証する仕組みではありません。窓口を作ることと、AIに選ばれることは別の話です。
NLWeb導入の前提と流れ:構造化データの整備から始める
最初の一歩は、サーバーの用意ではなく構造化データの点検です。材料が古かったり欠けていたりすれば、返る答えもその通りになります。
先にやること:構造化データの点検
自分で確認できるのは、商品や記事に付けた種類の指定、必須項目の抜け、更新されていない価格や在庫です。商品ページに埋め込む構造化データの最小形を示します。
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "商品名",
  "description": "商品の説明",
  "brand": { "@type": "Brand", "name": "ブランド名" },
  "offers": {
    "@type": "Offer",
    "price": "12800",
    "priceCurrency": "JPY",
    "availability": "https://schema.org/InStock"
  }
}
商品名・説明・ブランド名・価格は自社の値に書き換え、在庫の状態は実際の状況に合わせます。AI検索対策の全体像はAI検索の対策(AIO)の記事にまとめています。
NLWebを動かすのに必要な3つ
必要なのは、窓口を置く場所、意味で探せるデータベース、言語モデルの利用です。実装はMITライセンスで公開されているため、ソフトウェア自体に利用料はかかりません。費用がかかるのは、選んだ言語モデルの利用料と、データベースやサーバーの運用費です。
自分でサーバーを持たない道もあります。CDN大手のCloudflareは、自社の検索サービス(AutoRAG、現在のAI Search)でNLWebに対応しています(Cloudflare「Make your website conversational for people and agents with NLWeb and AutoRAG」、2025年8月)。管理画面でドメインを選ぶと巡回と索引作成を行い、窓口の配信まで用意できます(Cloudflare「AI Search リリースノート」、2026年10月確認)。2026年3月には、認証なしで公開できる窓口とAIエージェント向けの接続口(MCP)も加わりました(Cloudflare「AI Search UI snippets and MCP support」、2026年3月)。私たちも、構造化データの整備や、AIエージェントから呼べる状態にする実装を支援しています。
NLWeb導入を5ステップで進める
進め方は「棚卸し → 範囲を絞る → 試す → 質問例を集める → 公開範囲を決める」の5段階です。
- 構造化データを棚卸しし、抜けと古い情報を洗い出します。
- 対象のデータを商品か記事のどちらか1種類に絞ります。
- 公開前の環境で動かし、答えの精度を確かめます。
- 社内の問い合わせ履歴から、実際に来る質問の例を集めます。
- どこまで答えてよいか、公開範囲と接続の制限を決めます。
NLWebの限界と、いま対応するか様子見にするかの判断基準
現時点のNLWebは、まだ発展の途中にあります。公開から日が浅く、中心にあるのは一つの実装例です。マネージド提供やサイト基盤側の対応は出始めているものの(NLWeb.ai「What is NLWeb?」、2026年10月確認)、公開された導入数の集計はなく、普及の度合いは推計に頼るしかない状況だと見ています。
判断の材料は3つです。
- 商品・在庫・イベント・記事のように、一覧にできる情報が多いか
- 構造化データがすでに整っているか
- サイト内検索への不満が、実際に社内や顧客から出ているか
3つとも当てはまるなら試す価値があります。当てはまらないなら、構造化データの整備だけ進めて様子見で構いません。
注意点として、AIの回答は同じ質問でも揺れるため、入れた直後の数回で良し悪しを決めないでください。生成AIが事実でない内容を返すハルシネーションも、窓口を作れば自動で消えるわけではありません。対処の手順はハルシネーション対策の記事で扱っています。AI検索で引用される条件そのものを知りたい場合は、GEOの記事が入口になります。
まとめ
NLWebの正体は、サイトに自然な言葉で質問できる窓口を用意するための、公開された取り決めと実装例です。MCPはつなぐ作法、llms.txtは案内の紙であり、どれも役割が違うので置き換え関係にはありません。
先に手を付けるべきは構造化データの整備で、実装は自社の情報量と不満の有無を見て判断すれば間に合うと私たちは考えています。自社がAIの回答にどう出ているかを数値で確かめたい方は、無料AIO診断(実測)から次の一歩を試してみてください。