「AIに社名を聞いたら、まったく別の会社の説明が返ってきました」という取り違えは珍しくありません。この取り違えを直す取り組みがエンティティSEOです。 検索エンジンやAIは「株式会社◯◯」という文字列ではなく、その名前が指す会社そのものを見分けようとします。この「名前が指す対象」をエンティティと呼びます。公式サイト、各種プロフィール、第三者の記事がばらばらだと、同じ会社として束ねられません。
本記事が扱うのは、検索やAIが見分ける人・会社・製品・場所としてのエンティティだけです。データベース設計やHTMLで使う同じ言葉は扱いません。AI検索での最適化を指す言葉は、AIO(AI Optimization)のほかにLLMO(Large Language Model Optimization)、GEO(Generative Engine Optimization)、AEO(Answer Engine Optimization)などがあり、業界でまだ呼び方が統一されていません。本メディアではこれらを総称して『AIO』と表記します。
なぜAI検索は自社名を同名の別会社と取り違えるのか
AIが自社を別会社と混ぜて語る原因の多くは、文章の質ではなく、会社の情報がばらばらに置かれていることにあります。公式サイト、採用ページ、SNSのプロフィール、第三者の紹介記事で、社名や事業内容の書き方が食い違っている状態です。読み取る側に、同じ会社だと判断する手がかりがありません。
起きやすいのは、次のような症状です。
- 同じ名前の別会社の事業内容が混ざって説明される
- 変更前の社名で案内され、新旧が別の会社として語られる
- 英語表記で質問すると、関係のない企業が出てくる
確かめ方は後半の点検の節でまとめて扱います。
ここで名乗っておくと、私たちはAIの回答を継続して取得し、企業がどう語られているかを可視化している株式会社AI Hackです。私たちは、まず疑うべきは記事の出来ではなく、会社情報の不一致だと考えています。
エンティティは「実体」、キーワードは「文字列」:SEOでの意味を切り分ける
キーワードは文字の一致を見る単位で、エンティティは対象そのものを見分ける単位です。同じ「山田商事」でも別の会社のことがあり、「㈱山田商事」と「山田商事株式会社」は同じ会社です。文字だけを見ていると、この二つを取り違えます。
キーワードは文字の一致、エンティティは会社そのものの見分け
検索は文字列ではなく物事を扱う方向へ進むと、2012年の時点で宣言されています(Google「Introducing the Knowledge Graph: things, not strings」、2012年5月)。ここから読み取れるのは、検索が文字の一致だけでなく「どの対象の話か」を手がかりにしている、ということです。下の表は、その見方の違いを並べたものです。
観点 | キーワード中心の考え方 | エンティティ中心の考え方 |
|---|---|---|
見る単位 | 文字列 | 会社・製品・人などの対象 |
一致の判定 | 文字がそろっているか | 同じ対象を指しているか |
増やすもの | 対応するページ | 対象を指し示す手がかり |
崩れる原因 | 文字の不足 | 表記の食い違い |
確認方法 | 検索順位 | 社名で聞いたときの説明の正しさ |
要点は、順位を上げる話と、取り違えをなくす話は別だということです。
ページを増やしてもエンティティは強くならない
記事を量産すると文字列は増えますが、どの会社を指すかは変わりません。必要なのは、社内外に散らばった自社の情報を同じ一つの対象にひも付けることです。私たちは、ここを混同したまま記事を増やす施策が、最も時間を無駄にしやすいと見ています。
データベース設計の「エンティティ」との切り分け
システム開発では、データの項目のまとまりをエンティティと呼びます。HTMLでも、記号を書き表すための記述を同じ言葉で呼びます。本記事はどちらも扱わず、検索やAIが見分ける実在の対象だけを指します。
検索エンジンとAIは知識グラフの中で自社をどう束ねるのか
検索エンジンは、人・会社・製品を点、その関係を線として持つ事実の台帳を使っています。これを知識グラフ(ナレッジグラフ)と呼びます。自社という点に、所在地・事業内容・代表者・公式プロフィールといった線がつながっている状態を想像してください。
AIの回答は、質問をいくつかの小さな検索に分けて組み立てられます。途中で別会社の情報を拾えば、その断片がそのまま回答に混ざります。分解の仕組みはAI検索が質問を分解する仕組みの解説で詳しく扱っています。
研究の側でも、AIの事実の誤りを減らす手段として、外部の事実の台帳につなぐ方法が整理される一方、評価や整備の課題が残ると報告されています(Lavrinovics ほか「Knowledge Graphs, Large Language Models, and Hallucinations: An NLP Perspective」Journal of Web Semantics 85巻、2025年5月)。台帳につなぐこと自体が万能ではなく、つなぎ先が正しいかどうかが効いてきます。なお、検索エンジンやAIの内部処理は公開されていないため、本記事では観測できる事実と、そこからの解釈を分けて書きます。
次の図は、散らばった情報が一つの会社として束ねられるまでの関係を表したものです。
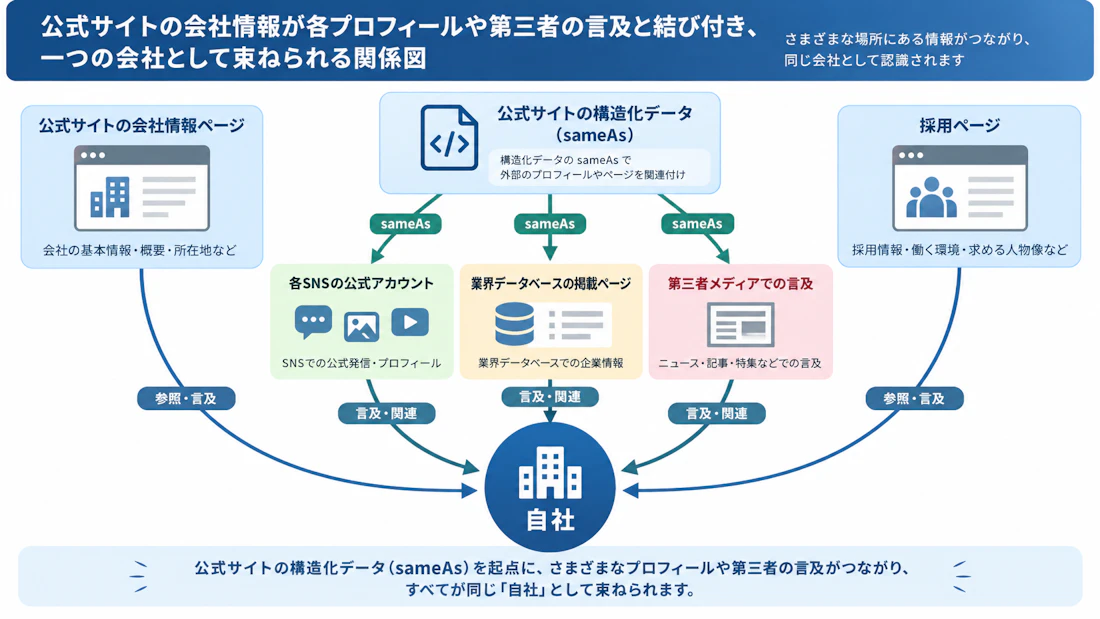
私たちは、束ねる手がかりを増やす作業が、記事を増やす作業より先に来ると考えています。
自社が別会社と混同される4つの典型パターン
混同は、原因ごとに起きる場所が違います。自社サイトの中で崩れている場合と、外部の情報が古いままの場合では、打つ手が変わります。下の表は、症状から対策を引けるように並べたものです。
混同の原因 | 起きること | 効く対策 |
|---|---|---|
同名・類似名の他社 | 他社の事業内容が混ざって説明される | 会社情報を1ページに集約し、公式プロフィールのURLを並べる |
表記ゆれ(全角半角、株式会社の前後、スペース) | 別の名前として扱われる | 全ページで社名の表記をそろえる |
旧社名やブランド名と法人名のずれ | 旧名で案内される、新旧が別会社として語られる | 沿革として旧社名を明記し、外部プロフィールも更新する |
英語表記と日本語表記の不一致 | 英語の質問で別会社が出る | 両方の表記を会社情報に併記し、外部でもそろえる |
このうち表記ゆれと旧社名のずれは、どちらも自社の手で直せます。次の図は、この4つの経路と対策の対応を1枚にしたものです。
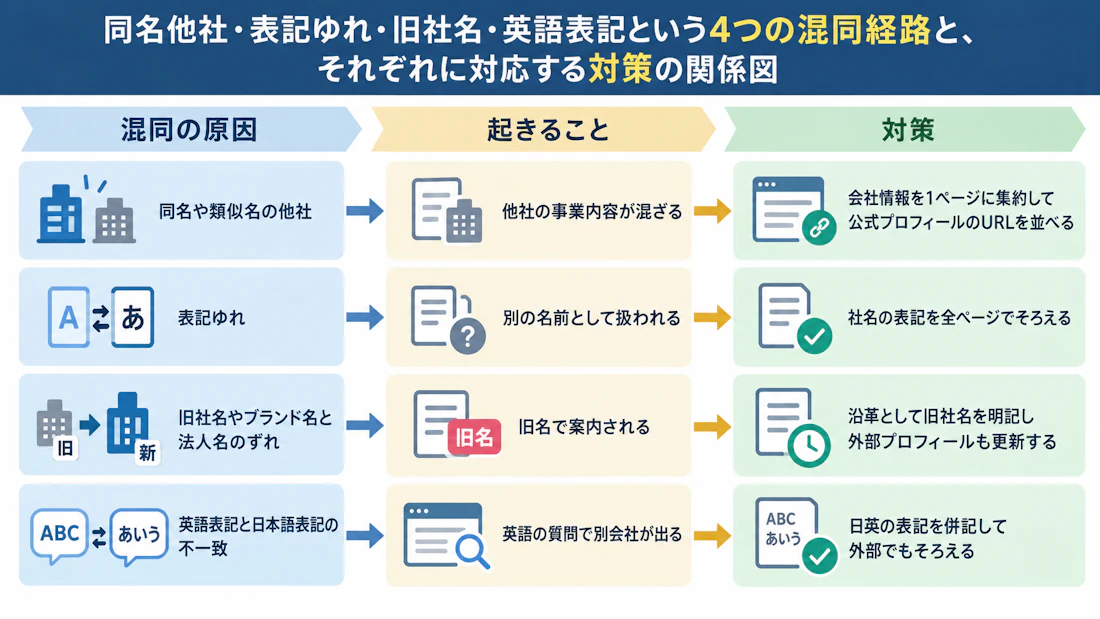
私たちは、まず自社サイトの中で崩れている箇所を直す方が、外部に働きかけるより結果が早いと考えています。
エンティティを確立する施策を、自社で統制できる順に並べる
着手の順番は、自分で決められるものから先です。外部の掲載や第三者の言及は相手がいるため、時間も読めません。この記事で挙げる施策は、次の5つです。
- 社名・事業内容・設立年の表記を全ページでそろえる
- 会社情報を1ページに集約する
- 会社情報を機械が読める形で書き、同じ会社だと示すURLを並べる
- 公式プロフィールの記載を自社サイトと一致させる
- 第三者サイトでの言及を増やし、外部のデータベースへの掲載を検討する
まず自社サイトで決められること(施策1から3)
施策1は表記の統一です。フッター、採用ページ、プレスリリースの社名を一字単位でそろえ、事業内容の説明文も一つに決めます。
施策2は集約です。会社情報が複数ページに散っていると、どれが正かを外から判断できません。1ページにまとめ、他のページからはそこへ案内します。
施策3は、その会社情報を機械が読める形で書くことです。この書き方を構造化データと呼び、会社の情報であることを示す型を指定して書きます。あわせて、別サイトにある自社の紹介ページのURLを並べる項目が sameAs です。SNSやレビューサイトのプロフィールなど、複数のURLを指定できます(Google 検索セントラル「組織(Organization)の構造化データ」、2026年11月時点)。
会社情報ページに置く記述の例です。
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "株式会社サンプル",
  "url": "https://example.com/",
  "logo": "https://example.com/logo.png",
  "sameAs": [
    "https://x.com/example",
    "https://www.youtube.com/@example",
    "https://www.example-media.com/company/sample"
  ]
}
社名・URL・ロゴの場所と、sameAs に並べるプロフィールのURLを自社の値に書き換えます。書き方の詳細と検証の流れは構造化データの実装手順と検証方法の記事に譲ります。
次に外部:公式プロフィールと第三者サイトでの言及(施策4と5)
施策4は、SNSや各種登録サイトのプロフィールを自社サイトと一致させることです。古い事業内容が残っていると、せっかく並べたURLが食い違いの元になります。
施策5は外部での言及です。外部で同じ説明が重なるほど、どの会社の話かを判別する手がかりは増えます。ただし回数そのものが効くとは限らず、記載内容が自社サイトとそろっていることが前提です。増やし方はサイテーションの増やし方をまとめた記事、誰が発信しているかを示す考え方はE-E-A-Tと信頼性の示し方の記事で扱っています。
外部のデータベースとしてよく挙がるのが、公開されている事実の集まりである Wikidata です。Wikidata には収録の基準があり、三つのうち一つを満たす必要があります(Wikidata「Wikidata:Notability」、2026年11月時点)。三つとは、ウィキメディアの各サイトへの有効なリンクがあること、公開された資料で確認できる明確な対象であること、データの構造上の必要を満たすことです。
構造化データを入れればAIの認識が変わる、という誤解
構造化データは、会社情報を取り違えなく読ませるための書き方であって、引用や順位を増やす仕掛けではありません。Googleは、生成AIの検索に構造化データは必須ではなく、追加すべき特別な記法もないとしています(Google 検索セントラル「生成AI機能向けの最適化ガイド」、2026年5月公開)。そのうえで、検索結果での特別な表示の対象になるため、SEO全体では使い続けることを勧めています。
もう一つの誤解は、書けば伝わるという前提です。サイト内の記述と外部での言及が食い違っていれば、束ねる手がかりは増えません。改善の順番は計測結果にもとづいて決めるのがよく、外部への働きかけより先にサイト内の食い違いを潰すべきだと私たちは考えています。
AIと検索で自社の見え方を点検する4つの手順
点検は、検索結果の確認、AIへの質問、会社情報の読み取り確認、指名検索の推移の4つです。
- 社名とサービス名で検索し、表示される会社情報に誤りがないかを確認する
- 主要なAIサービスに社名を聞き、事業内容・所在・沿革の誤りを記録する
- 構造化データのテストツールで、会社情報が読み取れているかを確認する
- Search Console の検索パフォーマンス画面で、社名・サービス名を含むクエリの表示回数とクリック数を、施策前後の同じ長さの期間(たとえば直近3か月とその前の3か月)で比べる
AIの答えは毎回同じにはならないため、複数のサービスで、日を変えて複数回確かめてください。確認の進め方はAI検索での見え方を確認する手順の記事にまとめています。回答を継続して取得し、言及・引用・誤りに分解して見ると、どのパターンの取り違えが残っているかを特定しやすくなります。
検索結果の横に出る情報枠をナレッジパネルと呼びます。前半で触れた知識グラフに集まった情報が、検索結果に枠として表示されたものだと考えると、両者の関係をつかみやすいでしょう。この枠は、ウェブ上の公開情報をもとに自動で作られ、表示を申し込む窓口はありません。認証を受けた本人からのフィードバックは優先的に処理され、本人確認後はソーシャルプロフィールへのリンクなど一部の情報が直接修正されます(Google ナレッジパネル ヘルプ「自分に関する情報についてフィードバックを送信する」、2026年11月時点)。認証の具体的な手順は本記事では扱いません。私たちは、パネルが出ること自体を目標に置くべきではないと考えています。
まとめ
エンティティSEOは、散らばった自社の情報を一つの会社として束ね直す作業です。今週できることは3つあります。会社情報ページの表記をそろえること、会社情報を機械が読める形で書いて公式プロフィールのURLを並べること、AIに社名を聞いて誤りを記録することです。順番を守れば、少ない手数で取り違えは減らせると考えています。まずは自社がいまAI検索と検索結果でどう認識されているかを確かめるところから始めたい方は、無料AIO診断(実測)の申し込みをご利用ください。