「Perplexityで自社名を調べると、出典に並ぶのは競合の記事ばかりなんです」。Perplexity SEOの相談は、企業のWeb担当者からほぼこの一言で始まります。Perplexityに引用されるかどうかは、自社サイトがPerplexityのアクセスを通しているか、そのうえで質問にそのまま答える形で書かれているかで決まります。 Perplexityは、質問のたびにウェブを検索し、回答に番号付きの出典リンクを添えて返すAI検索サービスです。この記事ではAI検索の入門解説には戻らず、企業サイト側で何を変えるかに絞って整理します。
AI検索での最適化を指す言葉は、AIO(AI Optimization)のほかにLLMO(Large Language Model Optimization)、GEO(Generative Engine Optimization)、AEO(Answer Engine Optimization)などがあり、業界でまだ呼び方が統一されていません。本メディアではこれらを総称して「AIO」と表記します。AI検索最適化の全体像はAIO(LLMO)とは?GEO・SEOとの違いとAI検索対策の始め方で扱っています。
「Perplexity SEO」が指すものは2つある
この記事が扱うのは、AI検索サービスのPerplexityのほうです。同じつづりの言葉に、言語モデルが次の単語をどれだけ予測しにくいかを表す指標のパープレキシティがあります。こちらは機械学習の性能を測る数値で、サイト運営とは関係がありません。以降は、AI検索のPerplexityに引用される状態をつくる取り組みを「Perplexity対策」と呼びます。
私たちは、AI検索での企業の見え方を計測するツールとコンサルティングを提供している株式会社AI Hackです。実務では、Perplexity対策を「通す・書く・確かめる」の3段階に分けて進めています。
Perplexityはウェブを検索して信頼できる情報源から回答をまとめ、答えの文のそばに番号を付けて元のページへ開けるようにしています(Perplexityヘルプセンター「How does Perplexity work?」、2026年11月確認)。
Perplexityはなぜ回答に出典リンクを並べるのか
Perplexityは、その場で集めたページを根拠にして回答を書きます。だから、根拠になったページへのリンクが回答に並びます。逆に言えば、その場の検索で集まらなかったページは、内容が良くても引用されません。
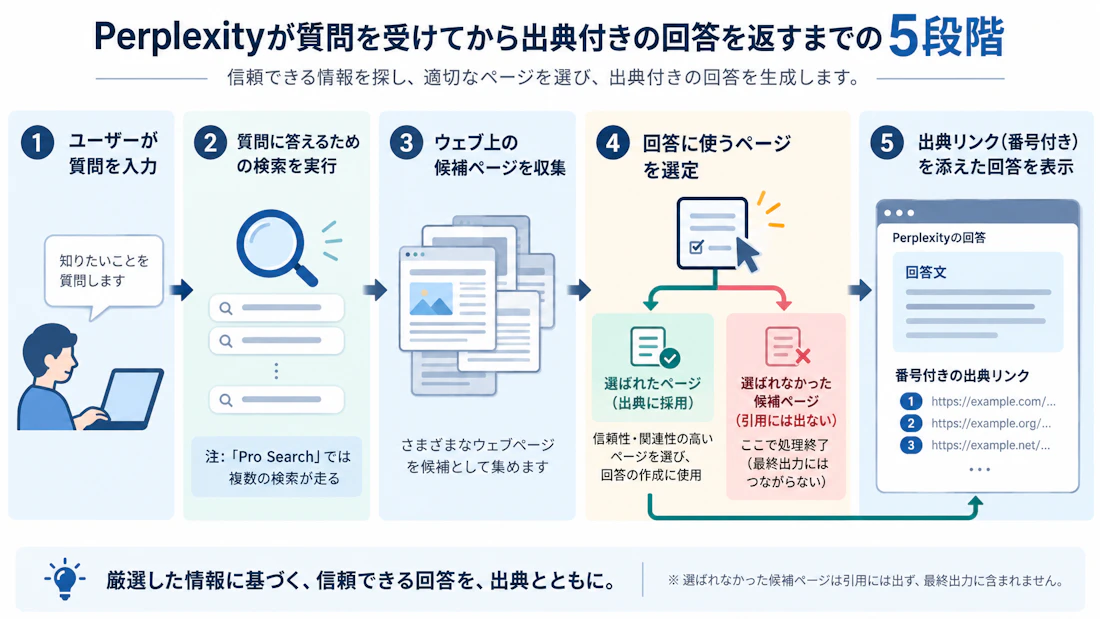
Perplexityが質問を受けてから出典を並べるまでの5段階
次の5段階のうち、質問の解釈・ウェブ検索・情報源の選定・番号付きの引用までは公式ヘルプに書かれている流れです。何回・どんな単位に分かれるかまでは公開されていないため、回数の見立ては観察による理解として読んでください。
- ユーザーが質問を入力する
- その質問に答えるための検索が行われる(対象プランではPro Searchが自動で適用され、1つの質問が複数回の検索に分かれることがある)
- 検索結果から候補のページが集められる
- 候補の中から、回答に使うページが選ばれる
- 回答文に番号付きの出典リンクが添えて表示される
1つの質問が複数の検索に分かれる動きは、AI検索が質問を分解する仕組み(クエリファンアウト)で詳しく扱っています。自社ページがどの段階で落ちているかを切り分けると、打ち手が決まりやすいと私たちは考えています。次の図は、質問の入力から回答が表示されるまでの順番を1枚にまとめたものです。
Perplexityは巡回と質問時の取得の二段構えで情報を集める
Perplexityは、ふだんの巡回で集めた情報と、質問の時点で取りに行く情報の両方を使います。公式の説明では、PerplexityBotは検索結果にサイトを出してリンクするための巡回、Perplexity-Userはユーザーの操作をきっかけにしたページの取得とされています(Perplexity「Perplexity Crawlers」、2026年11月確認)。質問時に取りに来る経路があるため、巡回を待たずに候補へ入る場合もあると見ています。
追加の質問をするたびに出典は選び直される
会話を続けると検索がやり直され、出典も選び直されます。1本の記事に関連情報をすべて詰め込む必要はありません。むしろ、1つの問いに1ページで答える粒度のほうが有利です。
PerplexityBotとPerplexity-Userは何が違うのか
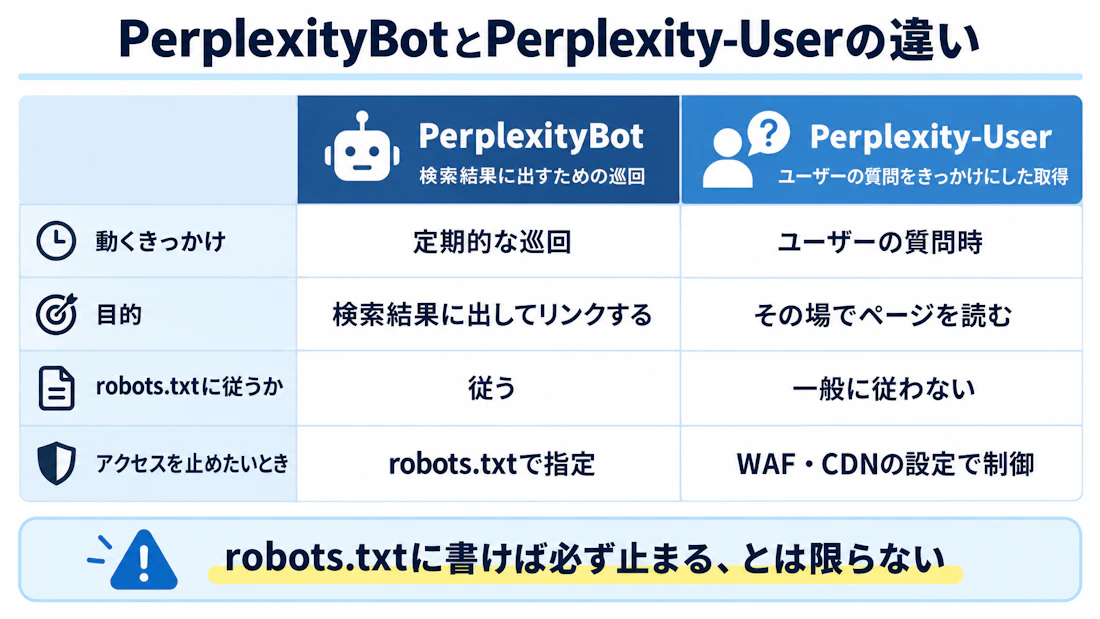
Perplexityには、2種類のアクセスがあります。ひとつは、ふだんから自動でページを集めて回る巡回です。もうひとつは、ユーザーが質問した、その瞬間にページを取りに来るアクセスです。前者をPerplexityBot、後者をPerplexity-Userと呼びます。
検索結果に出すための巡回がPerplexityBot
PerplexityBotは、Perplexityの検索結果にサイトを出してリンクするための巡回です。これを止めると、回答の候補に入る前の段階が切れます。検索結果に出したいなら、robots.txt(クローラーに対して、どこを取得してよいかを伝えるファイル)で許可します。
質問をきっかけに取りに来るのがPerplexity-User
Perplexity-Userは、ユーザーが質問した時点で動きます。人が求めた取得であるため、Perplexity-Userはrobots.txtの指定に従わないのが一般的です(先ほどのクローラー説明ページ)。つまり、robots.txtに書けば必ず止まる、という前提は成り立ちません。止めたい場合は、サイト配信の手前にある防御の設定(WAFやCDN)で遮断します。WAFは不正なアクセスを手前で遮断する仕組み、CDNはページを各地から配信する中継の仕組みで、どちらもサーバーに届く前にアクセスを止められます。
PerplexityBotとPerplexity-Userを止めたときに起きること
表は、2つが別物であることに注目して見てください。
項目 | PerplexityBot | Perplexity-User |
|---|---|---|
きっかけ | 自動の巡回 | ユーザーの質問 |
目的 | 検索結果に出してリンクする | その場でページを読む |
robots.txtでの名前 | PerplexityBot | Perplexity-User |
robots.txtに従うか | 従う | 一般に従わない |
止めたときに起きること | 候補に入る前段が切れる | 質問時の読み取りが切れる |
出典:Perplexity「Perplexity Crawlers」(2026年11月確認)
片方だけを通しても取りこぼしが残る、というのが要点です。なお、クローラー名やrobots.txtの扱いは提供側の方針で変わるため、仕様に関する記述は2026年11月時点のものとして扱い、公式の説明ページで都度ご確認ください。他社のクローラーも含めた考え方は、AIクローラーの種類とrobots.txtの判断にまとめています。次の図は、2つのアクセスを並べて見比べられるようにしたものです。
robots.txtとWAF・CDNでPerplexityのクローラーを通す設定手順
やることは、許可を書くことと、手前で弾いていないか確かめることの2つです。許可だけ書いて安心してしまう例が多いため、確認までを1セットにします。
robots.txtに書く許可の記述例
Perplexityの2種類のアクセスを許可する、最小の書き方です。
User-agent: PerplexityBot
Allow: /

User-agent: Perplexity-User
Allow: /
User-agentの行がクローラーの名前で、つづりが違うと指定が効きません。非公開にしたい場所がある場合だけ、その場所をDisallowの行で書き足します。
robots.txtだけではPerplexityのアクセスを制御しきれない理由
robots.txtは相手への依頼であり、強制力はありません。アクセスの振る舞いを促すことはできても、そのアクセスが本物かどうかは証明できません。ユーザーエージェント(アクセス元が名乗る文字列)は、誰でも同じ名前を名乗れるからです。許可はユーザーエージェント名と公開IPアドレスの組み合わせで行い、IPの一覧は更新される前提で見直します(先ほどのクローラー説明ページ)。
自社サイトがPerplexityのアクセスを弾いていないか確かめる
多いのは、許可したつもりが配信の手前で落ちている状態です。典型は、ボットの一括遮断、国や地域での遮断、きつすぎるアクセス回数の制限の3つになります。社内の運用を変えた覚えがなくても、防御設定の既定値が変わっている場合があります。
robots.txtを変えたあとにPerplexityの到達を確認する2つの方法
1つ目は、robots.txtの検証ツールです。検証ツールは、robots.txtの指定を読み取って、指定したURLが取得可能かを判定するツールを指します。クローラー名とURLを指定すると、そのページの取得が許可されているかを確かめられます。2つ目は、サーバーの記録です。ユーザーエージェント名で絞り込み、アクセス日時と応答のコードを見ます。200なら取得できており、403や429なら手前で遮断しているか、回数を絞りすぎています。
Perplexityに引用されやすいページの4つの条件
通ったあとは、書き方の話になります。条件は、結論の位置、一次情報、更新日、ページの構造の4つです。
- 質問への答えを、本文の冒頭1〜2文で言い切る
- 自社でしか出せない一次情報を1つ入れる(自社調査や事例の型。数値は出典と時点を添える)
- 更新日を、ページを開いた人が読み取れる形で示す
- 見出しと本文の内容を対応させ、1ページ1テーマで書く
条件2のような一次情報の作り方は、AIに引用されるコンテンツの作り方で詳しく扱っています。実務では、引用の有無だけでなく、どのドメインが出典に並んだかまで分解して見ています。
根拠になる研究もあります。テストクエリ200件で、書き換えた本文をファイルとしてPerplexityに読ませて検証した範囲では、最大37%の向上が報告されています(Pranjal Aggarwalほか「GEO: Generative Engine Optimization」(KDD 2024/arXiv:2311.09735)、2024年8月)。効いたのは、統計値を足す、引用を足す、出典を示すといった方向でした。一方、キーワードの詰め込みはほとんど効かず、Perplexityでの検証では手を加えない場合を約10%下回りました(同論文、Aggarwalほか、KDD 2024)。
次の表は、自分のページを見直すときのチェックリストです。
条件 | 確認ポイント | 直し方の一例 |
|---|---|---|
結論の位置 | 冒頭に前置きが続いていないか | 見出し直後に答えの1文を置く |
一次情報 | 他社記事の要約だけになっていないか | 自社の調査結果や実務の判断を1つ足す |
更新日 | いつ時点の情報か読み取れるか | 本文とページ上に更新日を出す |
構造 | 見出しと中身がずれていないか | 話題ごとにページを分ける |
4つとも、読者が読みやすい形に近づける作業です。
自社サイトがPerplexityに引用されているかを確かめる3つの手順
今日できる確認は3つあります。質問して見る、記録を見る、設定を照合する、の順に進めます。
- Perplexityで実際に質問する。自社名を出す質問と、顧客が使う課題の言葉での質問の2系統を用意し、日を変えて複数回試します。出典に自社ドメインが並ぶかを見ます。
- サーバーの記録でクローラーの到達を確かめる。ユーザーエージェント名でアクセス記録を絞り込みます。名乗りは誰でも真似できるため、公開されているIP一覧と送信元を突き合わせて本物か確かめます。
- robots.txtと防御設定を照合する。検証ツールで取得の可否を見て、落ちていれば手前の遮断設定を疑います。
質問文、実施日、回数、出た出典ドメインを一覧で残すと、施策の前後が比べられます。私たちは手作業の反復が続かないため計測を自動化し、反復の平均とばらつき幅で見ています。確認を続ける形に整えるには、質問文と実施日を固定した定点観測にします。なお、AIの回答は同じ質問でも揺らぎます。1回試して出なかったことを結論にしないでください。
Perplexity対策で企業担当者が陥りやすい誤解と限界
現場で繰り返し見かける誤解を3つだけ挙げます。どれも、対策の順番を間違える原因になりやすい点です。
- 許可すれば必ず引用される、ではありません。許可は候補に入るための前提で、どの候補を出典に選ぶかの基準は公開されていません。
- ユーザーの質問時の取得は、robots.txtでは止まりません。止めたいなら配信の手前で対応します。逆に、引用されたいのに手前で弾いている状態が、もっとも惜しい取りこぼしです。
- AI向けの案内ファイル(llms.txt)を置けば引用される、ではありません。この賛否はllms.txtの書き方と効果の賛否で整理しています。
もうひとつ、1つのAI検索で引用されても、他でも同じように引用されるとは限りません。Perplexityは回答ごとに出典を並べて見せますが、ChatGPTのSEO対策で扱ったとおり、サービスごとに出典の見え方も情報の集め方も異なります。私たちは、エンジンごとに確認を分けるべきだと考えています。
まとめ:Perplexity対策は「通っているか」の確認から始める
まず、2種類のアクセスを通します。次に、質問にそのまま答える形でページを書き直します。最後に、引用されているかを日を変えて確かめます。自社の現在地を実測から知りたい場合は、無料AIO診断(実測)をお問い合わせフォームから申し込めます。